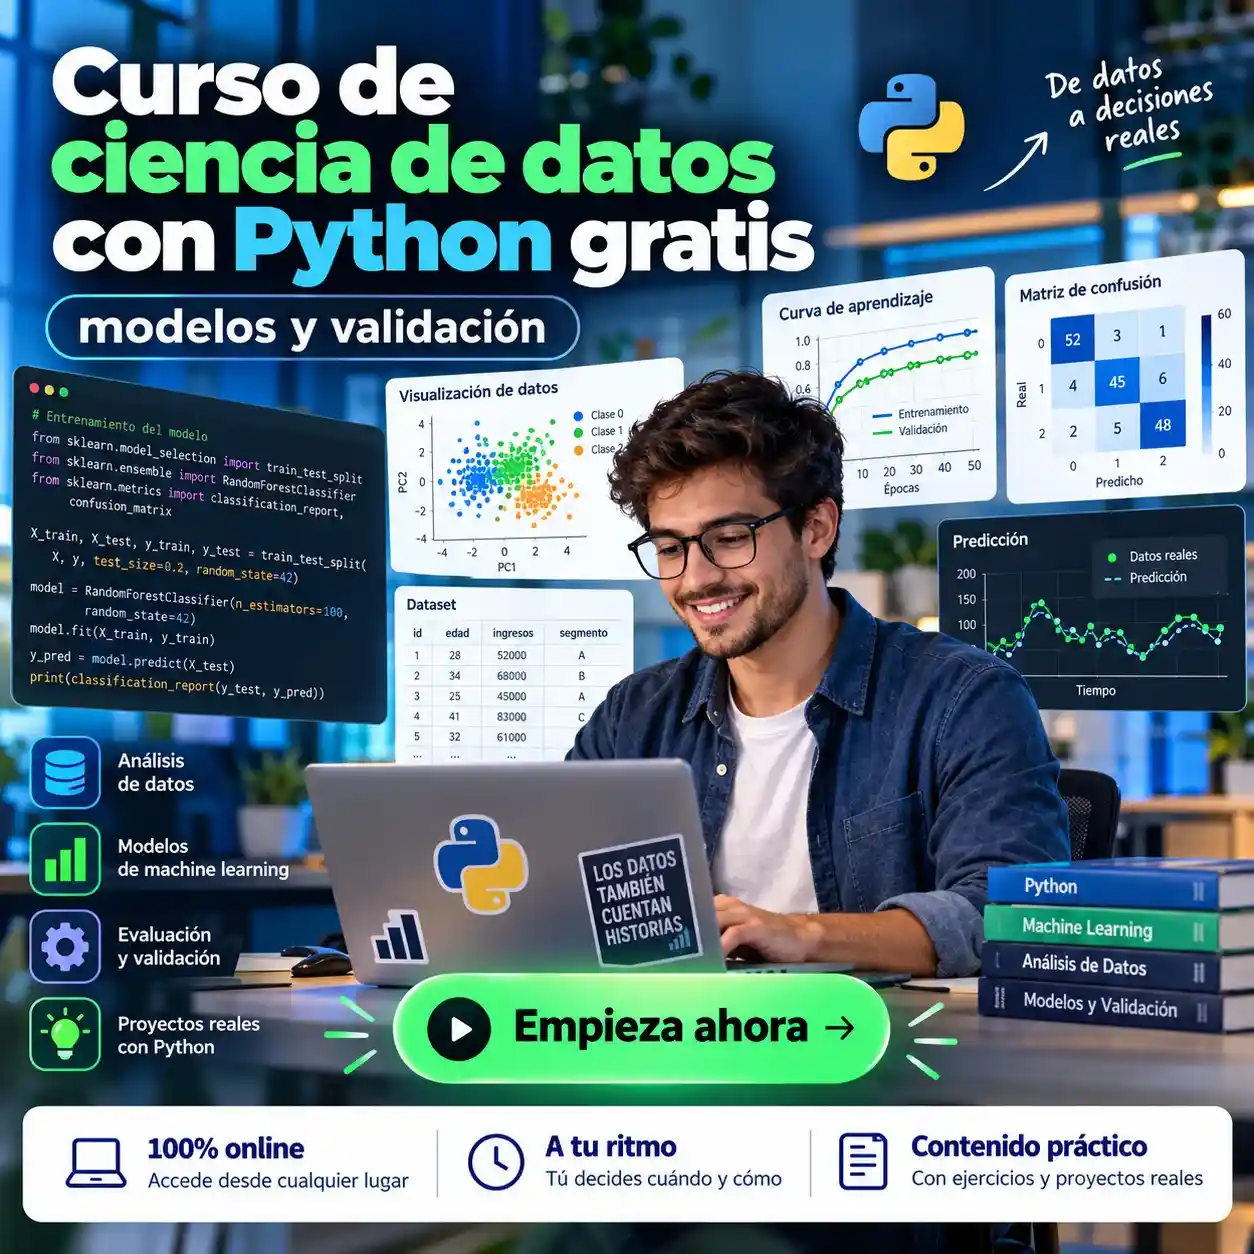
La ciencia de datos con Python se ha convertido en una de las competencias más demandadas para transformar información en decisiones, modelos predictivos y análisis que aporten valor real. Empresas, instituciones, investigadores y emprendimientos generan datos todos los días, pero el verdadero reto está en recolectarlos, limpiarlos, interpretarlos, modelarlos y comunicar resultados con claridad. Por eso, aprender ciencia de datos desde una ruta práctica puede abrir oportunidades en tecnología, negocios, salud, educación, finanzas y gestión pública.
El curso de ciencia de datos con Python disponible en Edutin se presenta como una alternativa gratuita dirigida a estudiantes y profesionales de ciencias de la computación, estadística, ingeniería y áreas afines. La plataforma indica que incluye actividades prácticas basadas en problemas reales, donde se realiza recolección, análisis de datos y desarrollo de modelos predictivos. También aborda fundamentos de ciencia de datos, modelos en Python, validación cruzada, sesgo, varianza, hiperparámetros, clasificación, regresión logística e inferencia estadística.
Este enfoque es relevante porque la ciencia de datos no consiste únicamente en ejecutar librerías. Un buen proyecto requiere comprender el problema, revisar la calidad de los datos, seleccionar variables, elegir modelos adecuados, validar resultados y explicar limitaciones. Sin ese criterio, cualquier modelo puede parecer impresionante en una demostración, pero fallar cuando se aplica a datos reales.
Por qué aprender ciencia de datos con Python
Python es uno de los lenguajes más usados para ciencia de datos por su ecosistema de librerías, legibilidad y comunidad. Permite trabajar con datos, automatizar procesos, construir modelos, crear visualizaciones y preparar prototipos. Para estudiantes, Python facilita iniciar porque su sintaxis es relativamente clara. Para profesionales, permite conectar análisis con soluciones reales, reportes y productos de datos.
La ciencia de datos también exige pensamiento estadístico. No basta con entrenar un modelo: hay que preguntarse si generaliza, si está sobreajustado, si los datos representan el problema, si las métricas son adecuadas y si el resultado puede explicarse. El curso menciona validación cruzada, sesgo, varianza, regularización, clasificación y regresión logística, temas esenciales para pasar de análisis exploratorio a modelado responsable.
Qué aprenderás en este curso de ciencia de datos
Edutin indica que el curso permite comprender fundamentos de ciencia de datos, implementar modelos en Python, capturar relaciones complejas entre variables, seleccionar modelos apropiados, usar validación cruzada para evaluar generalización, evitar sobreajuste, comprender el equilibrio entre sesgo y varianza, ajustar hiperparámetros, aplicar clasificación, regresión logística, regresión logística multinomial, bootstrap, intervalos de confianza y pruebas de hipótesis. La duración estimada señalada es de ocho semanas, con dedicación sugerida de una a dos horas por semana.
| Bloque de aprendizaje | Qué se estudia | Aplicación práctica |
|---|---|---|
| Fundamentos y regresión | Regresión lineal, errores y comparación de modelos | Predecir valores y entender relaciones entre variables |
| Modelos multilineales y polinómicos | Relaciones complejas, selección de variables y ajuste de modelos | Mejorar modelos cuando una relación simple no es suficiente |
| Validación y regularización | Cross-validation, sesgo, varianza, ridge y lasso | Evitar sobreajuste y evaluar si el modelo generaliza |
| Clasificación | KNN, regresión logística y clasificación multinomial | Resolver problemas de categorías, segmentación o riesgo |
| Inferencia y evaluación | Bootstrap, intervalos de confianza, pruebas de hipótesis y selección de modelos | Comunicar resultados con incertidumbre, evidencia y límites claros |
Revisa la ruta del curso y empieza a construir modelos de análisis predictivo con una base más sólida.
Ver el curso gratuito de ciencia de datosBeneficios para estudiantes, analistas y profesionales
Para estudiantes de programación, estadística o ingeniería, el curso puede ayudar a conectar teoría con problemas aplicados. En lugar de aprender fórmulas aisladas o código sin contexto, el estudiante trabaja una ruta donde los modelos se relacionan con preguntas, datos y evaluación. Esa conexión es esencial para construir criterio profesional.
Para analistas de datos, la ciencia de datos con Python permite avanzar más allá de reportes descriptivos. Un reporte puede mostrar qué pasó; un modelo puede ayudar a estimar qué podría ocurrir bajo ciertas condiciones. Esa diferencia es importante en ventas, abandono de clientes, demanda, riesgos, segmentación, mantenimiento, educación y salud.
Para profesionales de negocios o gestión, aprender fundamentos de ciencia de datos mejora la capacidad de dialogar con equipos técnicos. No todos necesitan convertirse en científicos de datos avanzados, pero sí es útil entender qué significa validar un modelo, qué riesgos implica el sobreajuste, por qué las métricas importan y cómo se interpretan resultados.
- Comprender fundamentos de modelado y análisis predictivo.
- Implementar modelos en Python con criterios de evaluación.
- Usar validación cruzada para revisar generalización.
- Aplicar clasificación, regresión logística e inferencia estadística.
- Construir un proyecto demostrable para portafolio o mejora laboral.
Plan de estudio en ocho semanas
Durante la primera semana conviene revisar fundamentos de ciencia de datos, estructura de un proyecto y regresión lineal. En la segunda, practica regresión multilineal y polinómica con datos simples. En la tercera, trabaja selección de modelos y validación cruzada. En la cuarta, estudia sesgo, varianza, regularización y ajuste de hiperparámetros.
En la quinta semana, el foco puede estar en clasificación y KNN. En la sexta, trabaja regresión logística y clasificación multinomial. En la séptima, revisa datos faltantes e inferencia en regresión. En la octava, cierra con bootstrap, intervalos de confianza, pruebas de hipótesis y evaluación final del modelo. Lo ideal es usar un mismo conjunto de datos durante todo el proceso para observar mejoras.
Errores frecuentes al iniciar en ciencia de datos
Un error común es saltar directamente a modelos complejos sin entender los datos. Antes de entrenar cualquier algoritmo, se debe revisar calidad, valores faltantes, duplicados, variables irrelevantes, distribución y contexto. Un modelo sofisticado con datos mal preparados produce conclusiones débiles.
Otro error es confundir buen desempeño en entrenamiento con un modelo útil. Si el modelo memoriza los datos, puede fallar ante casos nuevos. Por eso, la validación cruzada, la separación de datos y la revisión de sobreajuste son pasos esenciales. El curso incluye estos temas, lo que permite desarrollar una práctica más rigurosa.
También es frecuente comunicar resultados sin explicar incertidumbre. Un análisis responsable debe señalar límites, supuestos, tamaño de muestra, variables excluidas y posibilidad de error. La ciencia de datos no elimina la incertidumbre; ayuda a gestionarla con método.
Preguntas frecuentes
¿El curso de ciencia de datos con Python es gratis? El acceso al contenido puede ser gratuito. La certificación puede ser opcional y de pago, según las condiciones vigentes de Edutin.
¿Cuánto dura? Edutin indica una duración estimada de ocho semanas, con dedicación sugerida de una a dos horas por semana.
¿Necesito saber Python? Es recomendable tener bases de programación y nociones de datos. El curso puede ayudar a organizar la ruta, pero se aprovecha mejor si el estudiante practica código constantemente.
¿Qué puedo construir al terminar? Un proyecto de análisis predictivo con limpieza de datos, modelo, validación, métricas y conclusiones documentadas.
Conclusión
El curso de ciencia de datos con Python gratis es una ruta útil para aprender modelos, validación y análisis predictivo con enfoque práctico. Su valor está en ir más allá de gráficos simples y abordar comparación de modelos, cross-validation, sesgo, varianza, regularización, clasificación e inferencia. Para aprovecharlo, conviene trabajar con un proyecto real, documentar decisiones y comunicar resultados con honestidad técnica.
Empieza con un problema concreto y usa Python para convertir datos en modelos, métricas y decisiones mejor sustentadas.
Acceder al curso de ciencia de datosNota: Surnoticias presenta esta alternativa con fines informativos. Las condiciones de acceso, contenidos, duración y certificación pueden ser modificadas por la plataforma responsable del curso. El acceso al contenido puede ser gratuito y la certificación puede ser opcional y de pago.